Comment nous avons créé un data scientist personnel pour tout le monde chez Notion

Par David Thomas
Technical Engineering Manager, Data Infrastructure
Chez Notion, les questions sur les données se heurtaient toujours au même obstacle : le temps de l’équipe en charge des données. Quand quelqu’un publiait un message sur Slack, un data scientist devait examiner la demande, trouver la bonne source, vérifier la définition, rédiger la requête et expliquer le résultat. Même les questions courantes pouvaient prendre des jours.
Pour raccourcir ce cycle, nous avons créé Data Scout, notre agent de données interne. Désormais, tout le monde chez Notion peut poser une question en langage courant et obtenir une réponse à partir de nos données gouvernées dans Snowflake. En deux mois, les demandes adressées chaque semaine à l’équipe en charge des données ont diminué d’environ 80 %. Les questions qui restaient autrefois en attente ne prennent plus que quelques minutes.
Ce changement a fait gagner un temps précieux aux équipes en charge des données. Au lieu de passer leur temps à extraire les mêmes chiffres ou à exécuter des variantes de la même analyse, elles peuvent se consacrer à des tâches plus stratégiques, où leur jugement et leur expertise sont indispensables.
Aujourd’hui, environ la moitié des employé·es de Notion utilise Data Scout. Mais ce qui a le plus changé, c’est la façon de travailler. Les équipes lui demandent des chiffres pour leurs recherches, leurs rapports et la préparation de leurs réunions. « Est-ce que tu as demandé à Data Scout ? » est devenue une question courante. Plus besoin d’ouvrir un ticket et d’attendre la réponse pour prendre des décisions basées sur des données.
Je suis data engineer et j’ai participé à la création de Data Scout. Cet article est destiné aux responsables d’entreprise qui souhaitent comprendre pourquoi nous l’avons créé et ce que cela nous a apporté. Il est également destiné à mes collègues data engineers qui veulent savoir comment nous l’avons créé. Je vais commencer par expliquer comment nos équipes utilisent actuellement Data Scout, puis j’aborderai les choix techniques et les compromis qui ont guidé sa création.
Oh-oh ! Il semble que votre bloqueur de publicités empêche la lecture de la vidéo.
Regardez-la sur YouTube

Comment les équipes de Notion utilisent Data Scout
Data Scout connecte les données gouvernées dans Snowflake aux connaissances de l’entreprise dans Notion et aux sources connectées comme Slack. Snowflake applique les autorisations de données, tandis que Notion contrôle l’accès à l’agent et à ses outils et fournit le contexte métier nécessaire pour comprendre chaque question.
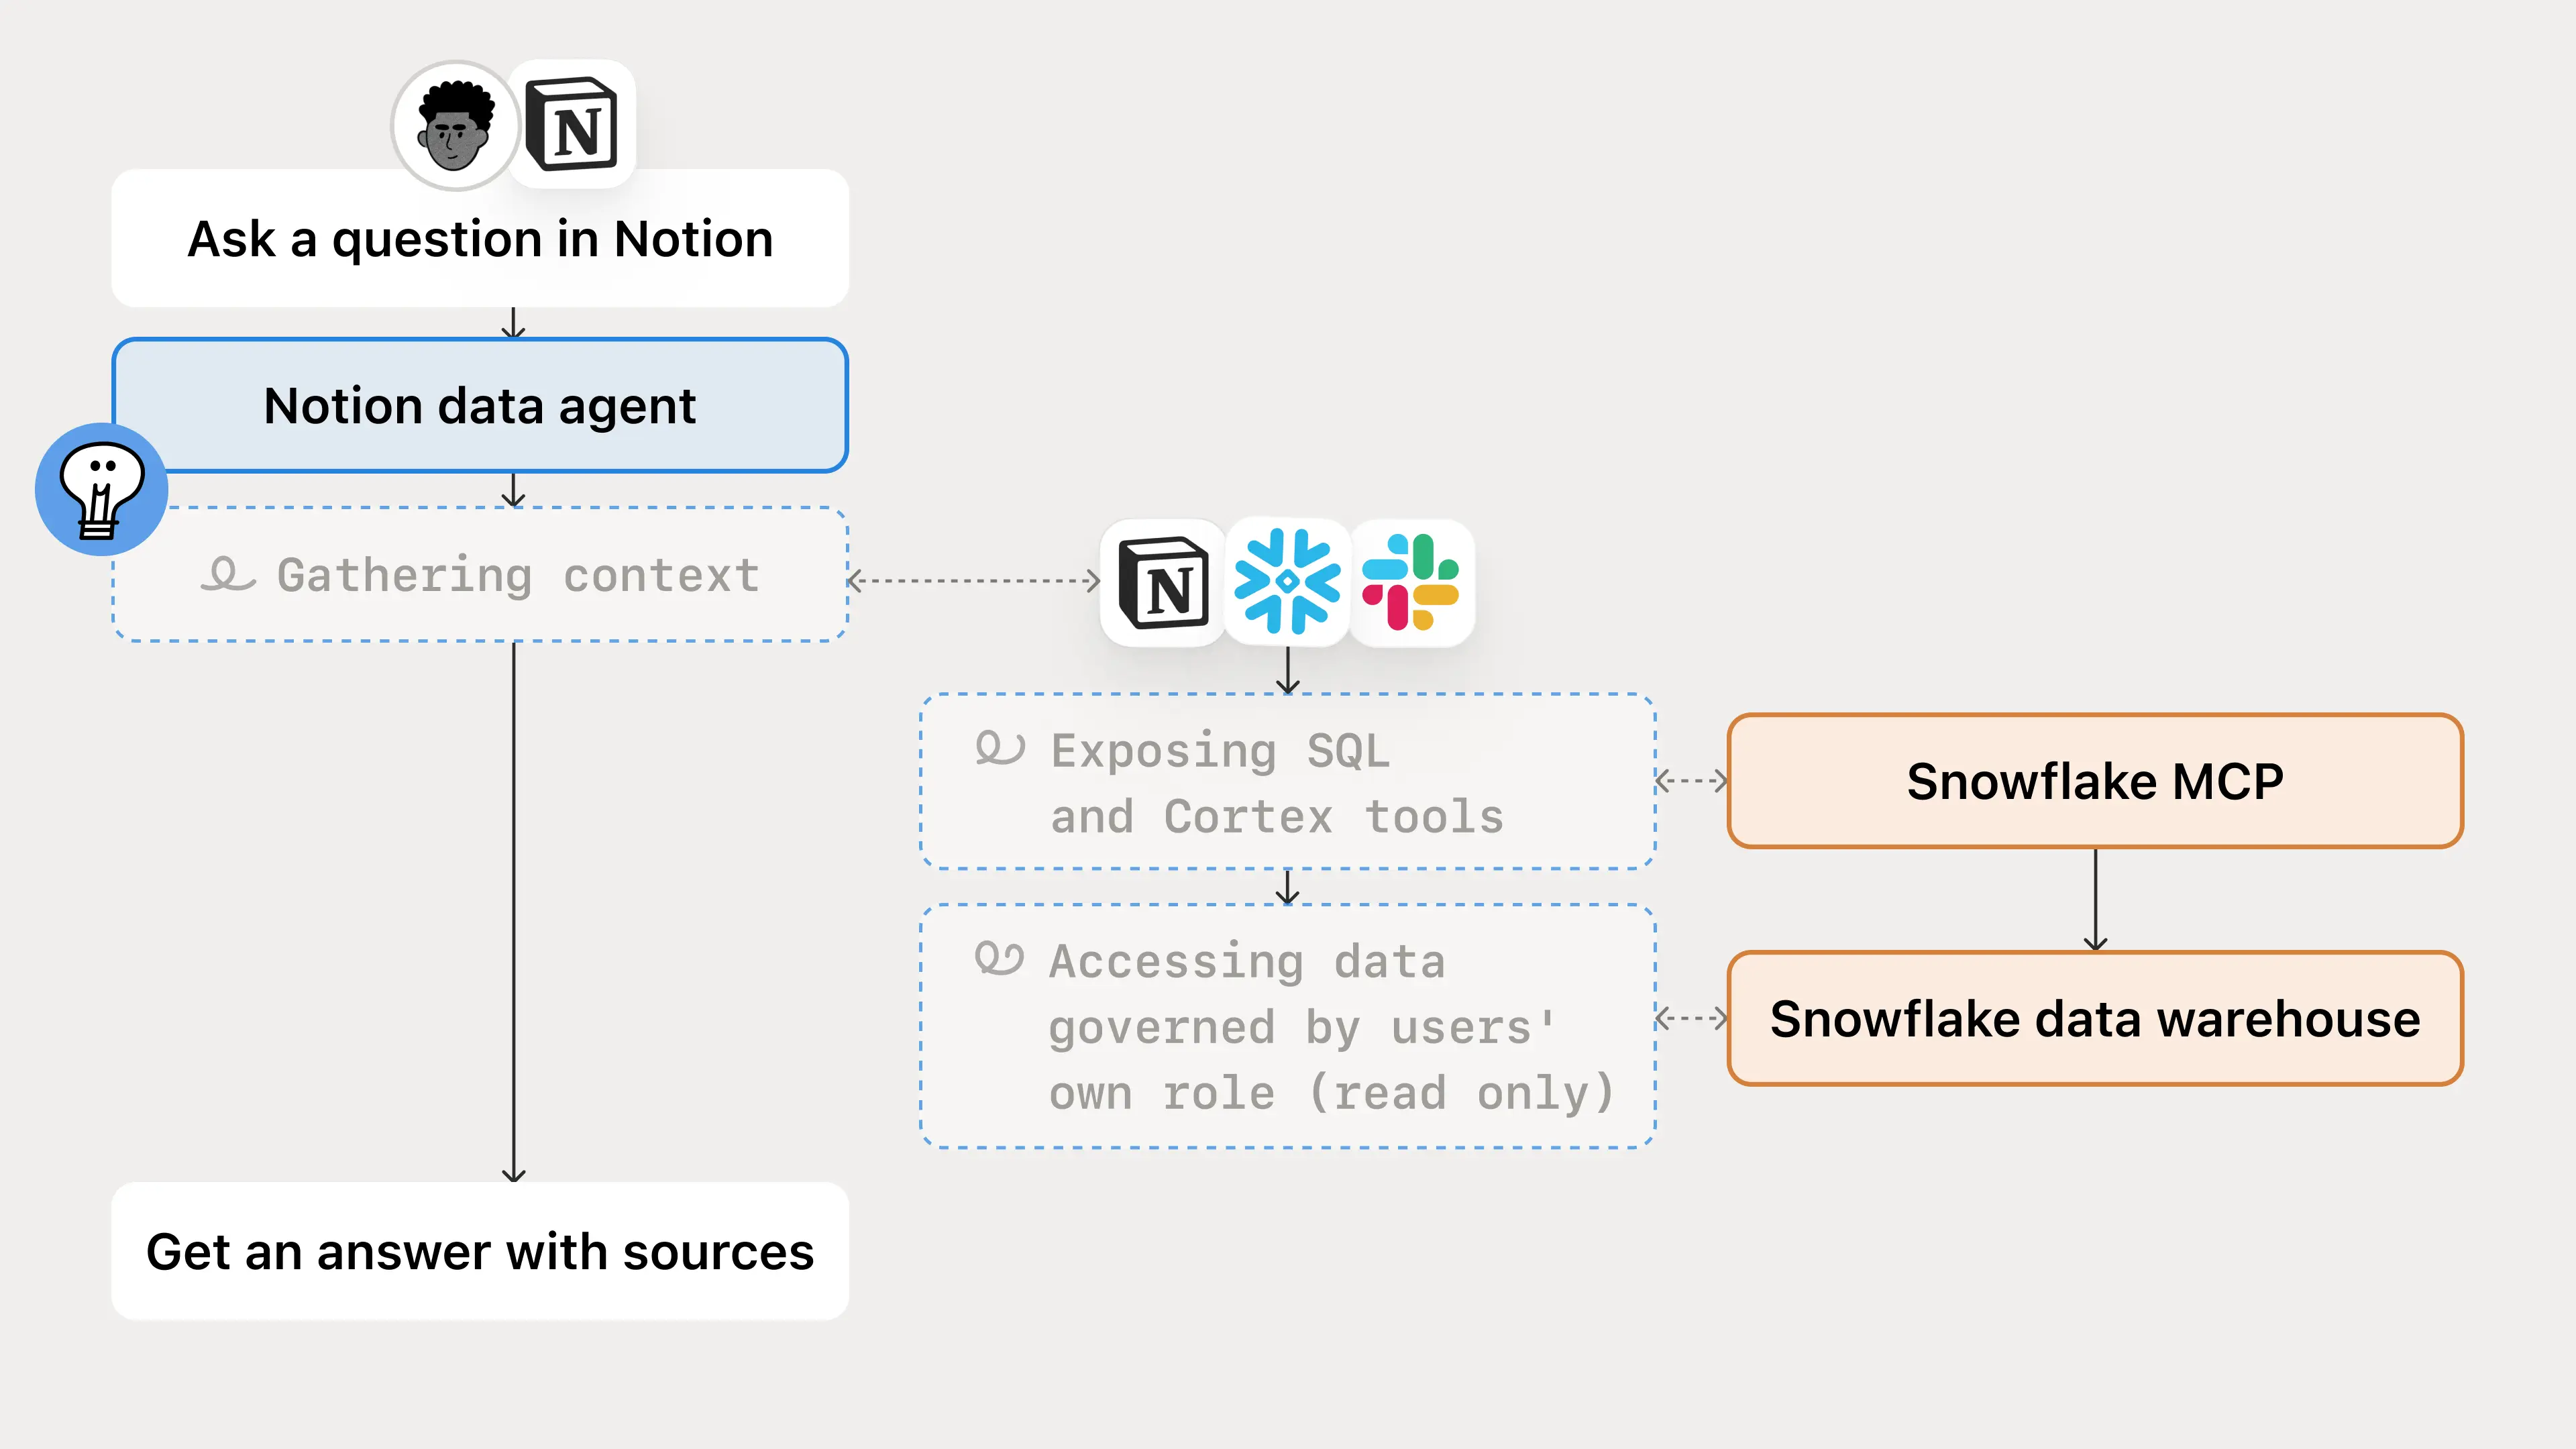
Cette base commune et ce modèle d’autorisation permettent à de nombreuses équipes d’utiliser le même agent pour prendre différentes décisions : l’équipe commerciale peut se renseigner sur l’adoption d’un compte, l’équipe produit peut examiner les abandons lors de l’intégration et l’équipe en charge de l’expérience client peut étudier le volume des demandes adressées au service d’assistance.
Nous avons soumis 200 vraies questions à Data Scout. Voici les thèmes les plus fréquents :
Équipe | Tâche récurrente | Question représentative |
|---|---|---|
Ventes | Utilisation des comptes, adoption de l’IA, licences, ARR, pipeline et propriété | Comment ce compte utilise-t-il Notion et l’IA dans ses espaces de travail ? |
Ingénierie | Comportement du produit et de l’IA, recherches d’identité et validation des données | Quels agents ou espaces de travail sont restés actifs et où le comportement a-t-il changé ? |
Expérience client | Volume de tickets, délai de première réponse, score de satisfaction client et contexte client | Qu’est-ce qui explique le volume de demandes et le temps de réponse de cette file d’attente du service d’assistance ? |
Produit | Adoption des fonctionnalités, intégration, activation et conversion | À quel stade les personnes abandonnent-elles l’intégration et en quoi cela varie-t-il selon la cohorte ? |
Marketing | Ciblage de comptes, adoption par les client·es, campagnes et pipeline | Quels comptes cibles utilisent déjà l’IA de Notion et où concentrer nos efforts de prospection ? |
Exemple de notre équipe GTM : comprendre l’adoption au niveau des comptes
Pour voir comment ces éléments s’articulent, suivons un membre de notre équipe GTM qui prépare le renouvellement d’un contrat client.
Il demande : « L’adoption de l’IA augmente-t-elle pour ce compte ? » Pour répondre, il faut choisir la bonne métrique d’utilisation et la bonne portée du compte, et connaître les objectifs du client ainsi que son plan de déploiement de l’IA. Data Scout combine les données d’utilisation de Snowflake avec les notes sur le compte et les réunions passées dans Notion pour déterminer si l’adoption suit le plan du client.
Une première réponse soulève souvent d’autres questions : « Quelles équipes contribuent à la hausse de l’adoption de l’IA ? » ou « Cette croissance vient-elle de nouvelles personnes ou d’un usage accru par les personnes déjà présentes ? » Plutôt que d’ouvrir une nouvelle demande de données pour chaque question, notre gestionnaire de compte peut approfondir son analyse dans la même conversation et arriver à la prochaine réunion de renouvellement avec une vision complète des changements.
Passer d’un agent de données unique à des workflows récurrents et spécialisés
Les questions ponctuelles n’étaient que le début. Au fil du temps, les équipes ont créé des agents qui se connectent à Data Scout via une connexion MCP partagée, réutilisant son accès aux données gouvernées et le contexte de l’entreprise. Deux autres modes de travail ont émergé :
Analyse récurrente : l’agent Data Scout Reporter se connecte à Data Scout pour transformer les spécifications de rapports enregistrées en rapports automatisés dans Notion et Slack. Les équipes peuvent ainsi suivre les mêmes indicateurs au fil du temps sans exécuter l’analyse chaque semaine.
Expertise sectorielle : les équipes ont créé des agents spécialisés avec des instructions plus précises pour leurs workflows, tout en continuant à tirer parti des données gouvernées et du contexte de Data Scout.
Data Scout est l’agent interne le plus utilisé chez Notion, mais les agents spécialisés ont aussi trouvé leur public. Le premier répond aux questions spontanées ; les autres mettent cette même base au service de workflows reproductibles et propres à chaque équipe. Mais plus les équipes et les agents réutilisaient cette base, plus il devenait difficile de garantir la fiabilité de leurs réponses.
Pourquoi une requête SQL qui fonctionne ne suffit pas
Nous avons constaté qu’une requête pouvait s’exécuter sans erreur tout en répondant à la mauvaise question. Le plus difficile était de garder la logique métier intacte à mesure qu’une question devenait une requête, et que la requête devenait une réponse. Prenons la question de l’adoption. Même si la requête SQL fonctionne, la réponse peut être erronée sur quatre aspects :
Le sens peut être erroné. Compter les appartenances à des espaces de travail plutôt que les personnes peut gonfler l’adoption, car une même personne peut appartenir à plusieurs espaces.
Le routage peut être erroné. L’agent peut trouver une table ou une connexion plausible sans trouver la définition à jour ni les filtres requis.
La mesure peut être erronée. Un changement dans la façon de suivre l’utilisation ou une correction des données historiques peut donner l’impression que l’adoption a augmenté ou diminué sans que les habitudes des client·es aient réellement changé.
L’interprétation peut être erronée. Même un chiffre exact peut être mal interprété. Une adoption qui semble stagner peut être conforme aux objectifs si le client ou la cliente déploie l’IA équipe par équipe. Ce contexte se trouve dans les notes du compte et les réunions passées dans Notion, mais pas dans Snowflake.
La leçon est claire : un contexte soigneusement préparé compte autant que la connexion elle-même. L’accès aux données n’indique pas à l’agent quelle définition privilégier, quelle source utiliser ni la signification d’un résultat pour l’entreprise. Cette connaissance doit avoir un ou une propriétaire chargé·e de la tenir à jour.
Comment nous créons et encadrons les agents de données
Notre approche repose sur un accès encadré aux agents et aux données, un contexte de données partagé et des instructions claires. Ensemble, ces éléments définissent les autorisations de l’agent, les connaissances qu’il utilise et le processus qu’il suit.
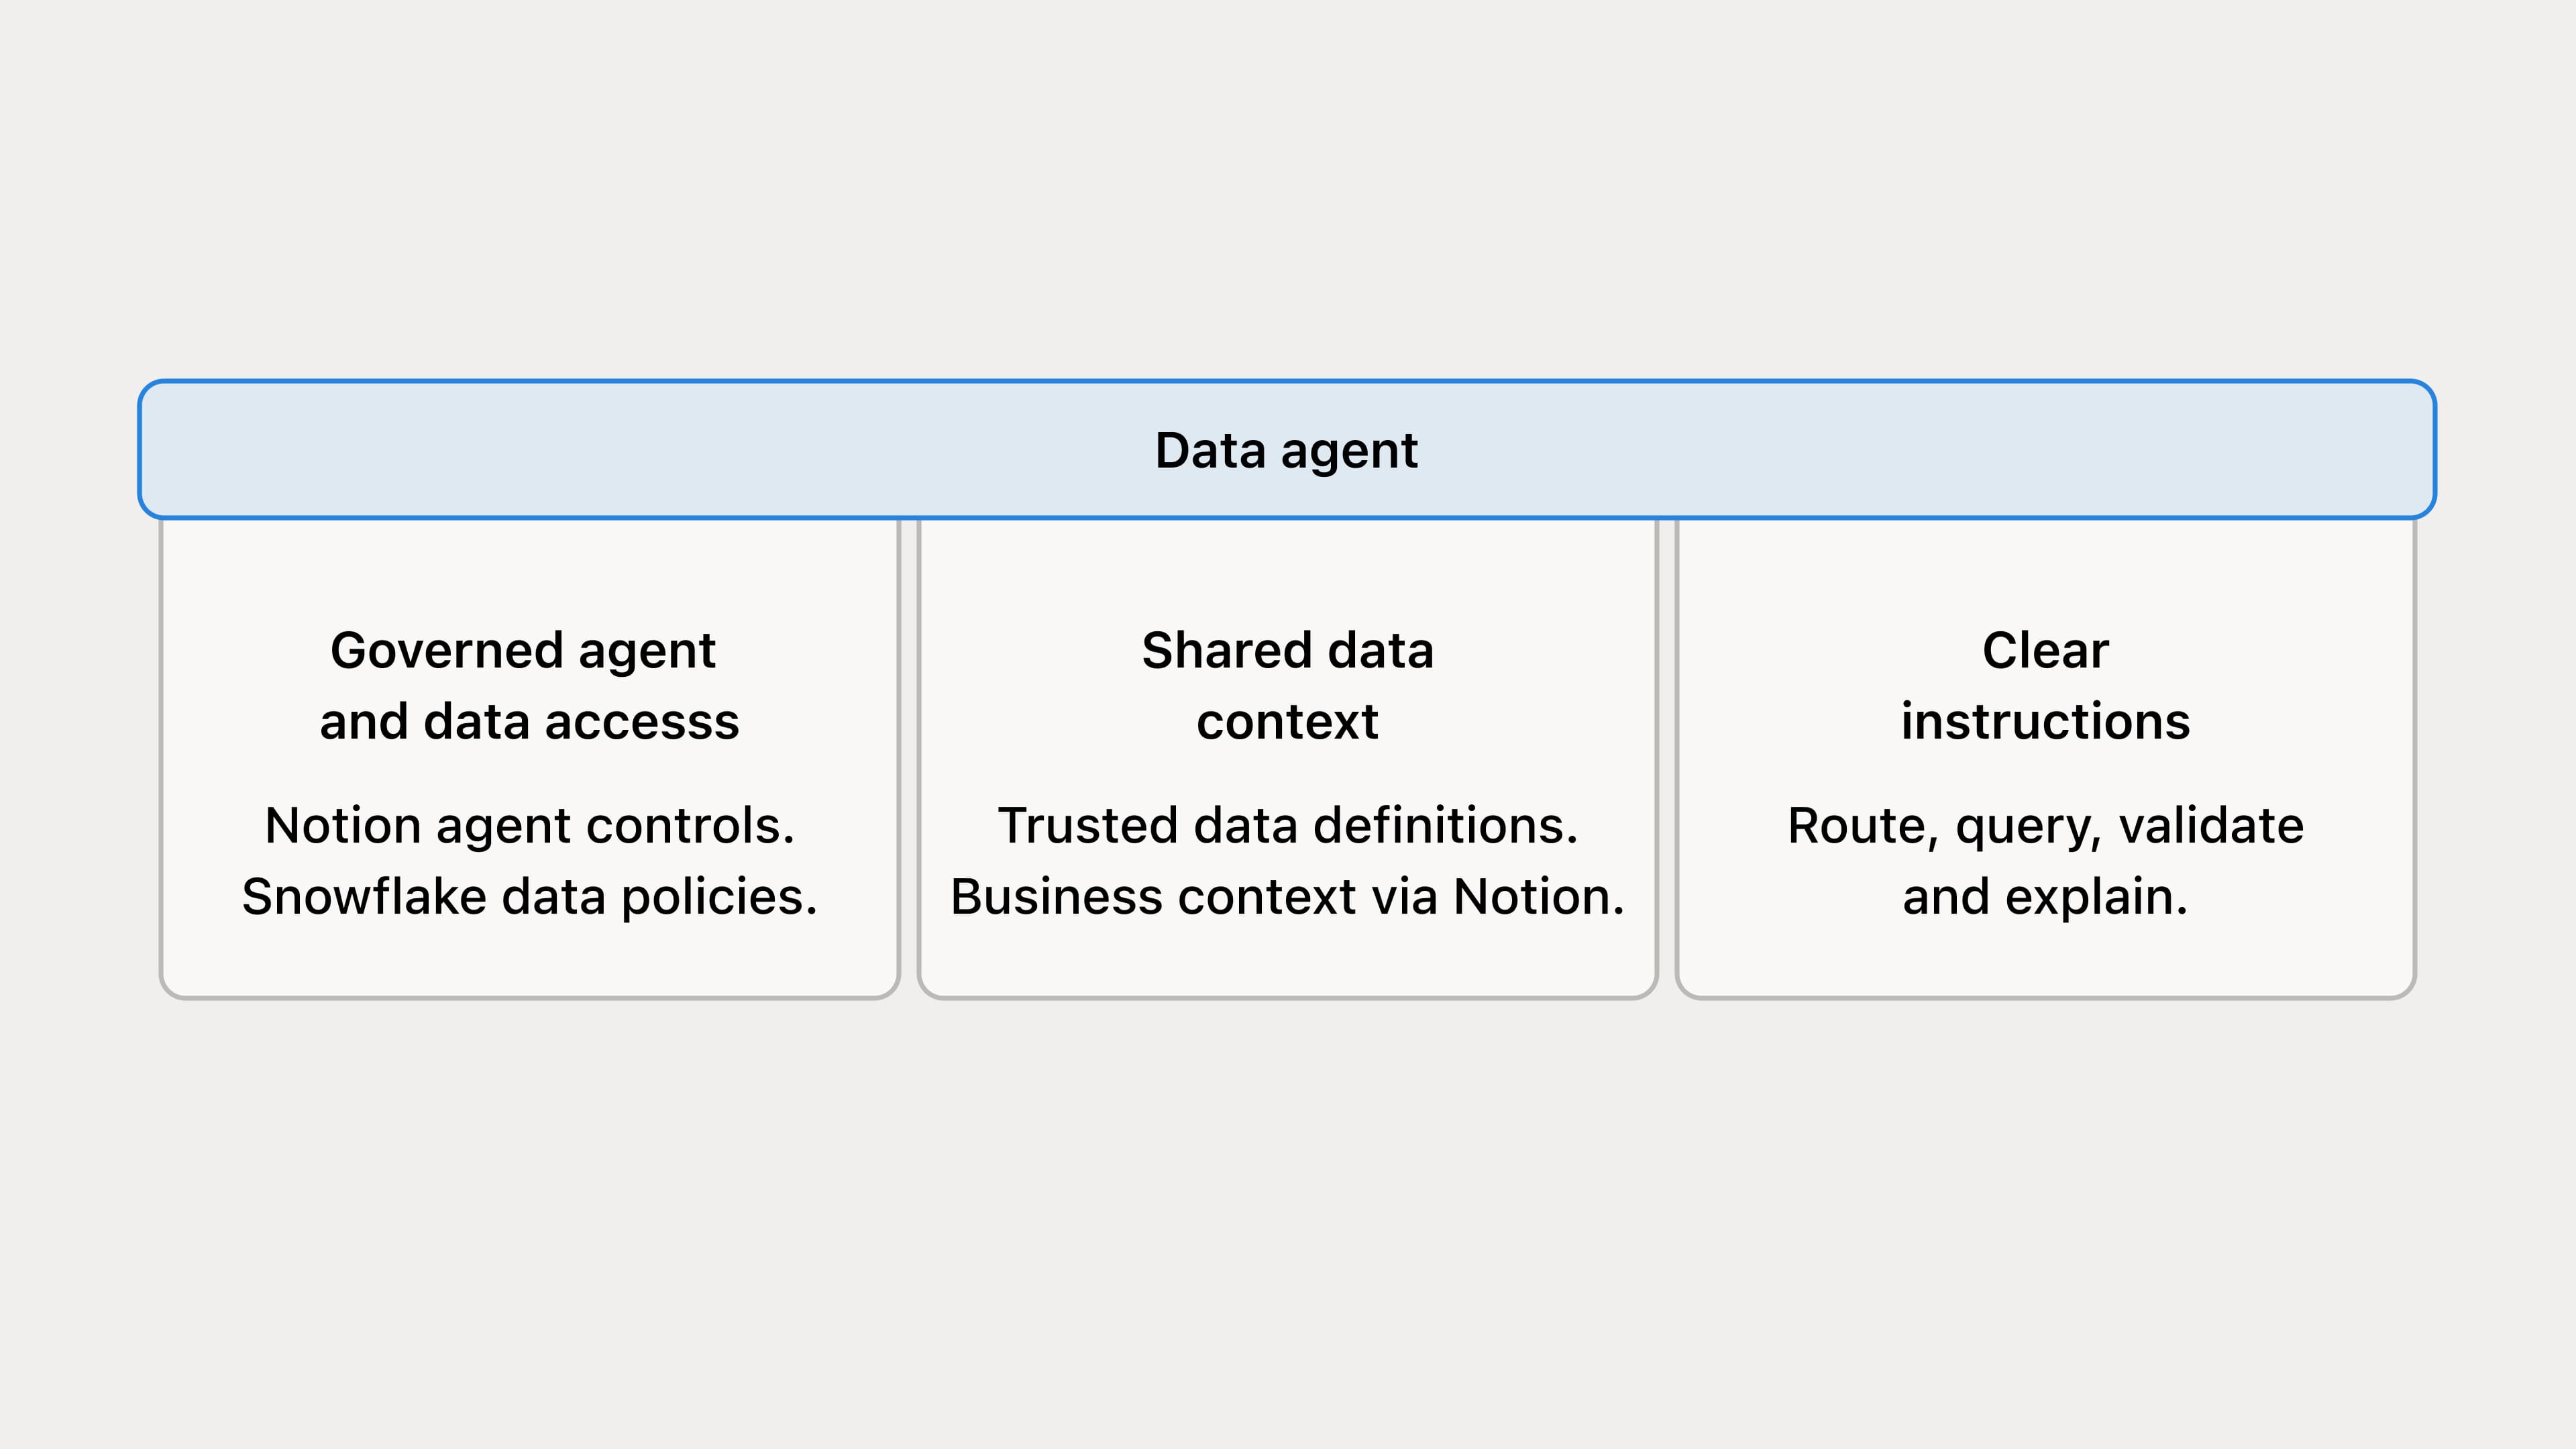
Ces piliers ne suffisent pas à garantir la fiabilité des réponses. Nous vérifions les résultats, examinons comment l’agent les a obtenus et mettons à jour les instructions à mesure que les données et l’activité évoluent.
Encadrer l’agent et son accès aux données
Notion et Snowflake encadrent différentes parties du workflow. Notion gère l’accès à l’espace de travail et les outils disponibles, tandis que Snowflake applique les autorisations d’accès aux données selon l’identité qui exécute la requête.
Les utilisateur·rices peuvent se connecter à Snowflake MCP via des custom agents ou leur agent Notion. Quel que soit le point d’entrée, chaque individu doit se connecter à Snowflake avec ses propres identifiants. De cette façon, les requêtes s’exécutent sous l’identité Snowflake authentifiée de cette personne, et les réponses reflètent son accès individuel aux données.
Les contrôles de données Snowflake appliquent les rôles et les autorisations accordées, ainsi que les politiques de masquage et de restriction au niveau des lignes, lorsqu’elles sont configurées. Ils limitent ainsi les privilèges aux données et aux actions nécessaires au workflow.
La requête du/de la gestionnaire de compte doit respecter les autorisations d’accès aux données de la connexion. Ses résultats doivent aussi être appropriés pour le rapport ou le canal dans lequel ils sont partagés. Un agent peut mettre la main sur des données difficiles à trouver, mais il ne peut pas contourner les contrôles d’accès.
Connecter les données et le contexte métier
Un contexte de données partagé permet aux agents de s’appuyer sur les mêmes spécifications et les mêmes documentations source. Notion est notre centre de référence pour le contexte métier : c’est là que l’agent trouve les plans, les décisions et les informations sur les client·es qui l’aident à comprendre la question.
Nous dissocions clairement les responsabilités, même lorsque les références cohabitent :
Le contexte de données régit le calcul : les indicateurs, les sources, le niveau de détail, les relations, les filtres requis et fraîcheur la récence des données.
Le contexte métier explique les objectifs, la terminologie de l’entreprise, l’historique client et les événements qui peuvent aider à interpréter le résultat.
Les instructions de routage sélectionnent les sources, connexions et outils approuvés, puis repèrent le contexte pertinent. Elles peuvent couvrir plusieurs connexions Snowflake ou différentes plateformes, et pas seulement les tables d’un même data warehouse.
Nous utilisons une base de données Notion comme index partagé des spécifications, des schémas, des skills et des changements de données connus. Chaque ligne correspond également à une page. Ses propriétés aident l’agent à trouver les instructions pertinentes, et son contenu rassemble les spécifications, procédures, avertissements et références dont il a besoin.
L’agent lit le contenu des pages sélectionnées et suit les références pertinentes, sans charger toute la base de données. Les métadonnées l’aident à trouver le bon contexte, mais ne le remplacent pas. Si une spécification se trouve ailleurs, l’entrée renvoie à sa source tenue à jour au lieu de la copier.
Notre choix s’est porté sur Notion car l’outil maintient le contexte directement lié aux plans, aux décisions et au partage de connaissances des client·es déjà gérés par nos équipes. L’agent peut lire une définition de métrique et les notes sur le compte qui l’expliquent dans le même espace de travail. Les propriétaires peuvent modifier et partager des pages qu’ils connaissent en s’appuyant sur les autorisations existantes de Notion. Quant aux agents, ils repèrent les entrées grâce à leurs propriétés, puis lisent le contenu des pages. Nous avons essayé de placer toutes les instructions dans les propriétés de la base de données pour les retrouver plus vite, mais cela surchargeait les métadonnées et compliquait leur mise à jour.
Le revers de la médaille, c’est qu’une bibliothèque de pages consultables ne permet pas d’imposer la définition des indicateurs, ni de remplacer une couche sémantique. Elle nécessite toujours des responsables clairement identifiés, des références de sources à jour ainsi qu’un processus de validation. C’est pourquoi nous maintenons la boucle de révision et de tri décrite ci-dessous.
Pour autant, Notion s’imposait comme la solution idéale. Ceux qui savent interpréter les données les exploitent déjà au sein de la plateforme, ce qui permet de lier directement le contexte aux projets qui font vivre ces données. Ce n’est cependant pas une obligation. Les client·es peuvent conserver leur expertise en données dans leurs outils existants, y compris Snowflake Semantic Views et Cortex Analyst, et la relier au contexte métier dans Notion.
Les instructions de routage restreignent la recherche avant la rédaction d’une requête, tout en séparant les définitions des données de leur interprétation métier. Ce modèle est donné à titre d’exemple : les systèmes connectés dépendent de votre configuration.
Organiser le contexte par domaine et par type de question
Nos instructions de découverte commencent par un ou deux domaines pertinents et les skills associés, avant de sélectionner des tables. Pour une recherche ponctuelle, une skill prioritaire qui correspond exactement à la question ou à une entrée des FAQ peut suffire. L’agent élargit sa recherche uniquement lorsque les instructions font défaut.
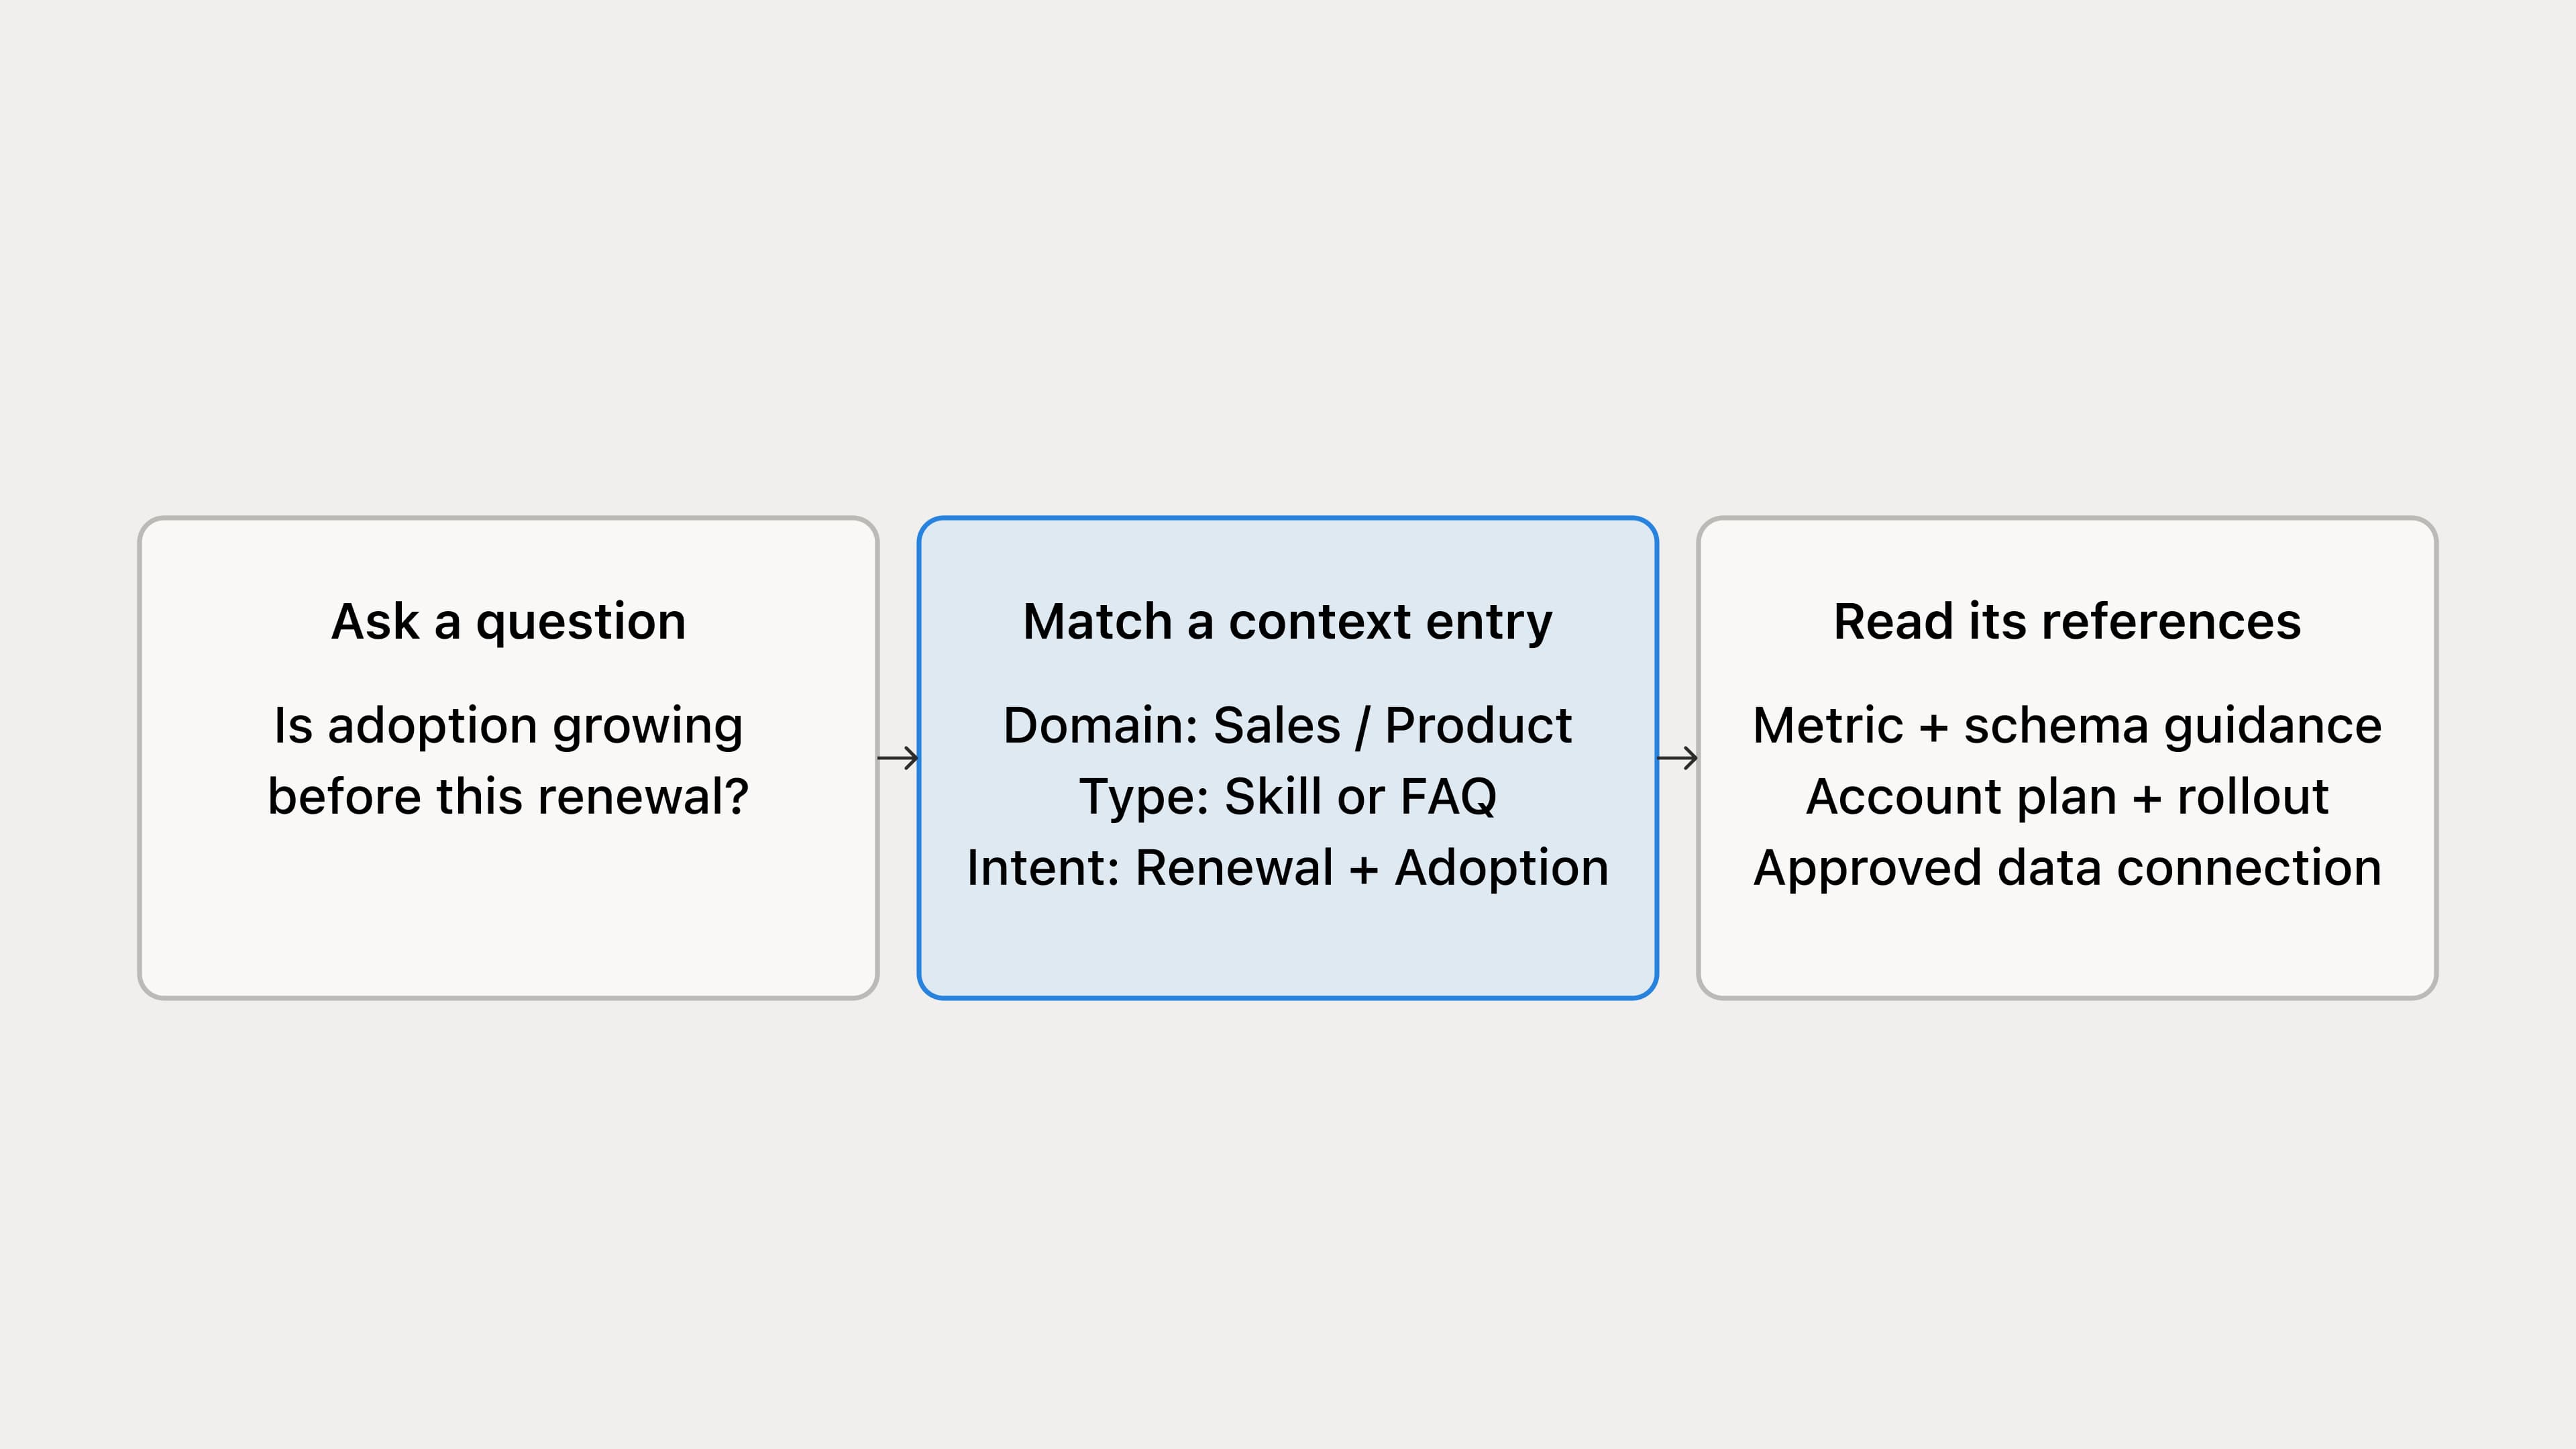
L’index aide l’agent à trouver la bonne page et à comprendre à quoi elle sert. Ces champs proviennent des instructions de découverte. Les valeurs sont données à titre d’exemple.
Champ | Objectif | Exemple |
|---|---|---|
Titre | Nommez l’entrée clairement | Adoption du compte avant le renouvellement |
Domaine | Préciser le domaine d’activité | Ventes, Produit |
Type | Indiquer comment utiliser la page | Skill, Définition de métrique, Schéma de table, Questions fréquentes |
Description/mots clés | Faire correspondre l’intention avec des termes familiers | Renouvellement, adoption, examen du compte |
Priorité | Ordonner les instructions pertinentes | Priorité de recherche définie par l’équipe |
Chaque ligne s’ouvre sur une page avec des titres cohérents. Une skill courte pourrait ressembler à ceci :
Le type compte : une skill fournit la procédure, une définition de métrique précise le calcul et un schéma de table indique le niveau de détails, les filtres, les jointures et les avertissements. L’entrée renvoie à la définition tenue à jour au lieu d’en créer une autre version.
L’état de révision, la récence et la propriété des données restent importants. La priorité détermine l’ordre dans lequel les entrées sont trouvées, pas leur approbation ni leur accès.
Des instructions claires pour une analyse reproductible
Pour être utile, un bon contexte doit être exploité de manière cohérente. Des instructions claires aident l’agent à choisir les bonnes sources, à vérifier son travail et à s’arrêter lorsqu’il n’est pas en mesure de justifier une réponse.
Une fois la question et la source identifiées, une exécution réussie nécessite encore une étape de validation avant la génération de la réponse.
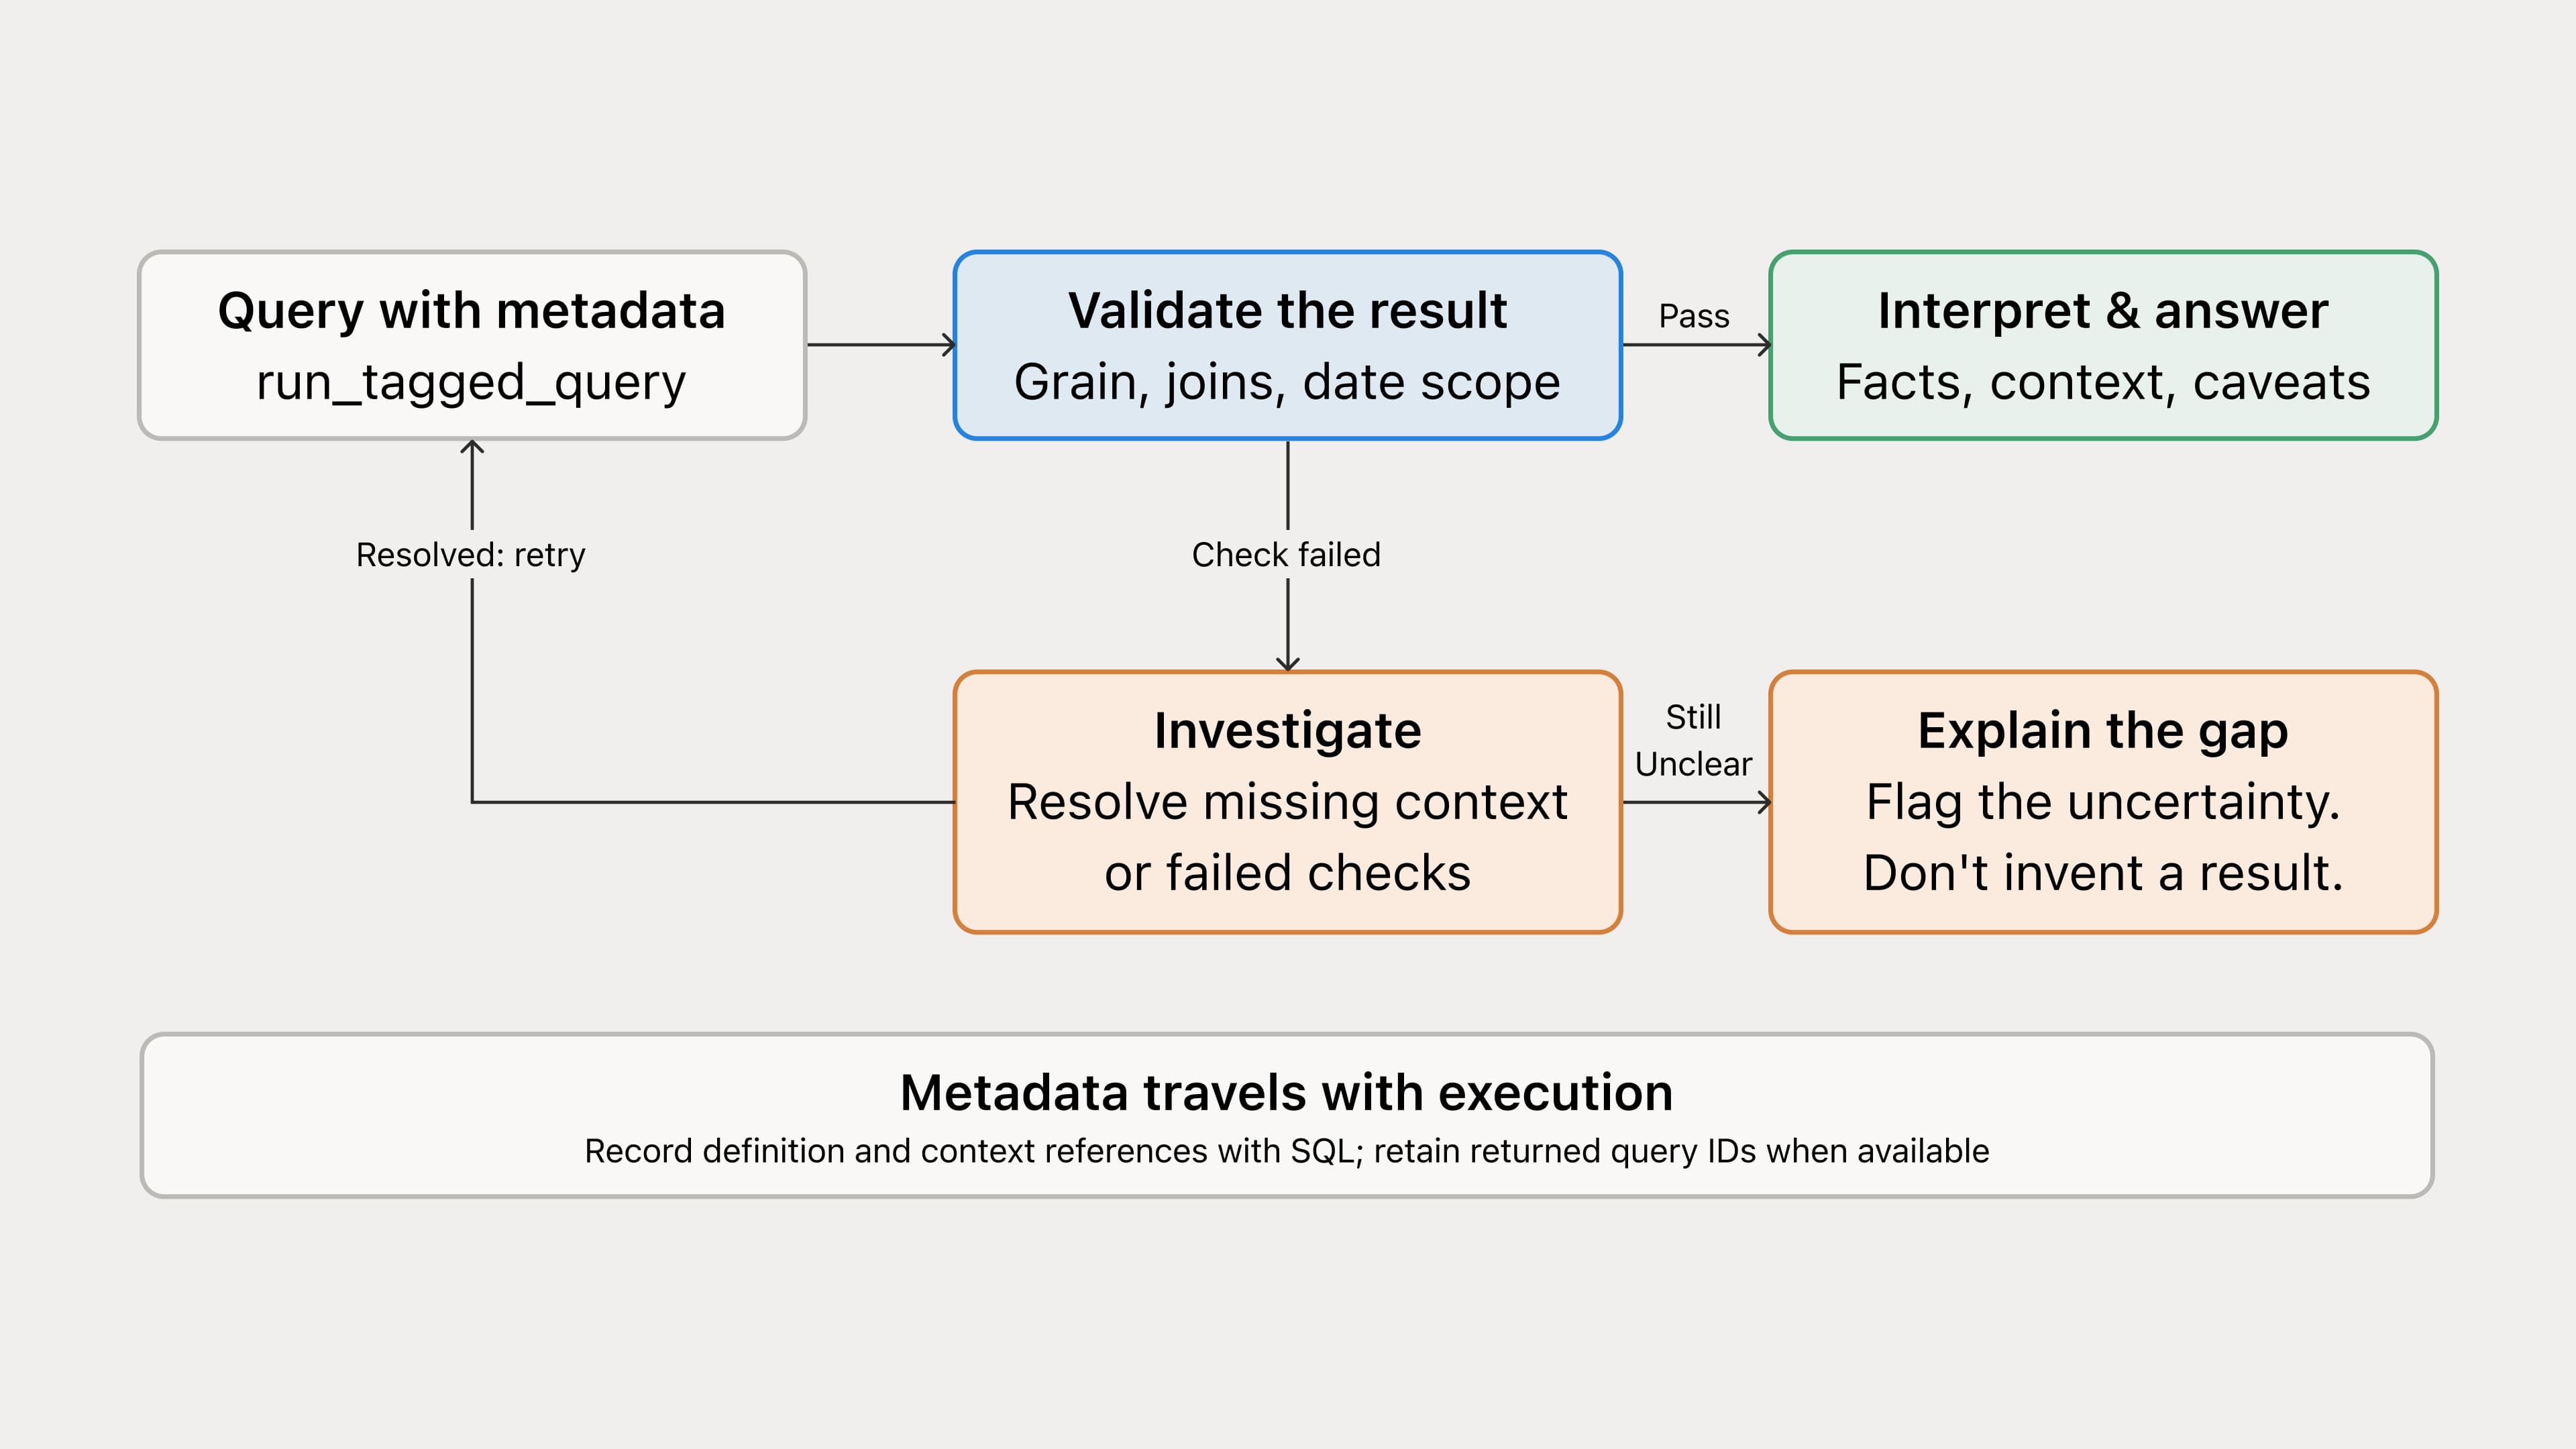
Les instructions de découverte indiquent quoi faire en cas d’échec. Si une colonne requise n’est pas documentée, examiner le schéma correspondant. Si Snowflake signale un identifiant invalide, vérifier le schéma au lieu d’essayer un autre nom plausible.
Lorsque les instructions chargées décrivent déjà les champs requis, l’agent peut les exploiter sans avoir à récupérer de nouveau l’ensemble du schéma. Il s’agit là de choix stratégiques visant à optimiser l’utilisation des requêtes ou des appels de récupération.
Déterminer la métrique, le compte ou la population, la période et la comparaison avant de procéder au calcul.
Orienter la requête vers la connexion et la source approuvées, puis utiliser les conseils pertinents du domaine ou la skill correspondant(e).
Vérifier la logique de requête et les données renvoyées, les relations entre les tables, les filtres, les dénominateurs et les périodes incomplètes.
Signaler les définitions manquantes, les accès refusés et les vérifications ayant échoué au lieu de trouver une solution de contournement.
Différencier l’incertitude concernant un nombre de l’incertitude concernant son explication.
Commencez par le résultat et les éléments qui l’étayent. Ne montrez les requêtes intermédiaires dans la réponse principale que si elles aident à la vérifier.
Revenons à l’exemple de l’adoption par les comptes. Avant d’interpréter la tendance par rapport aux objectifs du compte, Data Scout vérifie la fiabilité de la mesure :
Vérification de l’entité : l’association des comptes aux espaces de travail couvre l’intégralité du client ciblé, sans générer de doublons de personnes ou d’activités.
Vérification de la métrique : le numérateur, le dénominateur, les exclusions et les périodes respectent la définition tenue à jour.
Vérification des données : la période est suffisamment complète pour être comparée, et les changements de suivi connus ou les backfills sont pris en compte.
Vérification à une date donnée : si une source contient une ligne par entité et par jour, on utilise une seule date pour connaître l’état actuel. Une période de plusieurs jours risque de compter plusieurs fois la même entité ; elle est donc utilisée uniquement pour analyser une évolution dans le temps.
Vérification de l’interprétation : la réponse distingue clairement le changement mesuré des explications possibles trouvées dans les notes de déploiement ou les échanges avec les client·es.
Le ou la gestionnaire de compte peut poser des questions de suivi et consulter les sources. L’équipe de gestion du compte reste responsable de la décision.
Maintenir les données et le contexte métier à jour
Les données et l’activité de l’entreprise évoluent sans cesse : les instructions qui les accompagnent doivent suivre. Le contexte de données change avec les modèles, les définitions et les systèmes sources. Le contexte métier évolue avec les objectifs, les décisions et l’activité des client·es. Chez Notion, nous tenons ces instructions à jour à l’aide de custom agents dont la portée est définie, et non à l’aide d’automatisations de base de données. Chaque nuit, un agent de révision examine les conversations et les requêtes de Data Scout, Slack, Notion et GitHub pour repérer le contexte manquant, obsolète ou contradictoire, puis consigne ses observations. Un agent de tri élimine ensuite les doublons, apporte des petites corrections justifiées et confie les cas ambigus ou plus risqués à une personne pour examen approfondi.
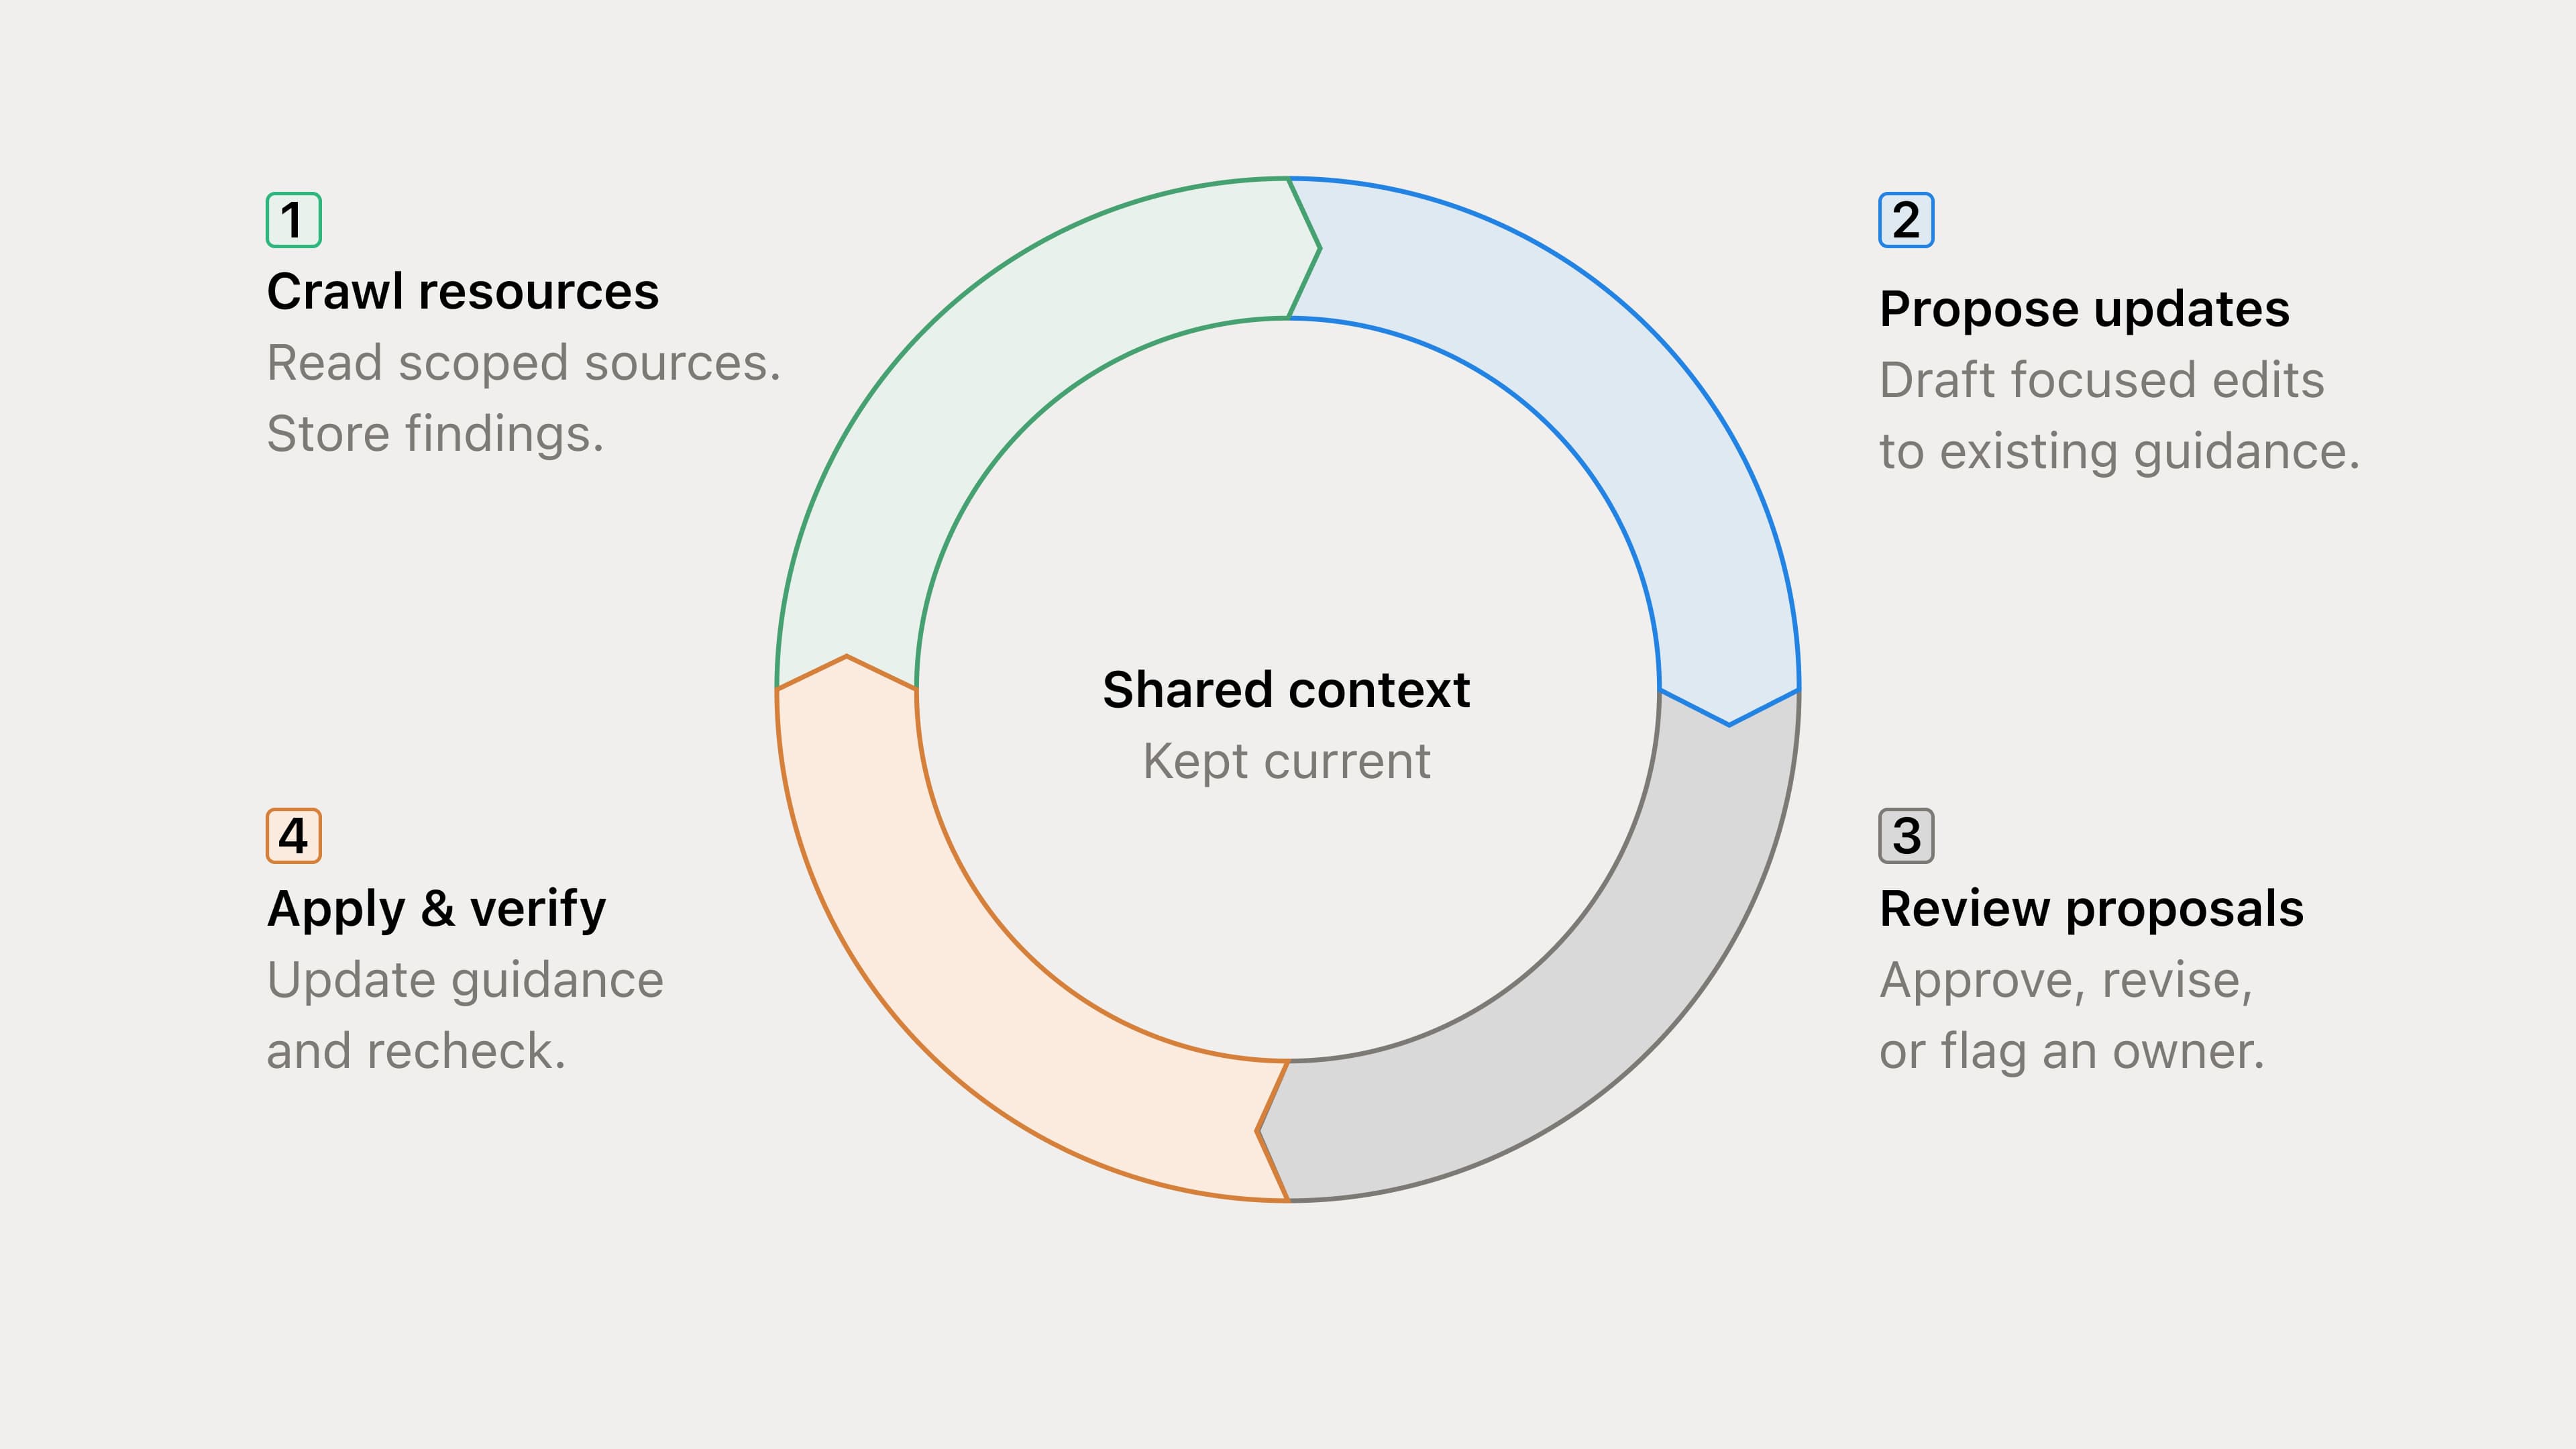
Ce processus de validation permet de bien dissocier le constat d’un changement de l’autorisation de le déployer.
Une preuve ne vaut pas approbation. Une correction sur Slack justifie une vérification, mais n’autorise pas à réécrire une métrique.
« Fusionné » ne veut pas dire « déployé ». Une pull request ne prouve pas que le changement est en production ni que la mise à jour des données historiques a été effectuée.
Examiner avant de réutiliser. Appliquez uniquement les changements autorisés, conservez les modifications humaines plus récentes et valider les mises à jour. Tout changement ambigu ou critique doit être remonté au/à la propriétaire.
Dans l’exemple de l’adoption, si le nom d’un événement change ou si un incident est résolu, il peut être nécessaire de mettre à jour les instructions associées à la source de données. L’agent doit alors s’appuyer sur les instructions mises à jour et validées, plutôt que de modifier lui-même leur interprétation lorsqu’il formule sa réponse. Des instructions complémentaires expliquent comment ces modifications sont examinées et traitées.
Voir ce que l’agent a vraiment fait
Notre outil d’exécution de requêtes,run_tagged_query, rassemble les métadonnées et l’exécution en un seul appel. Il ajoute ces métadonnées structurées sous forme de commentaire JSON directement dans le code SQL, puis appelle en interne l’outil de requête Snowflake habituel.
Les métadonnées peuvent inclure la métrique canonique, la référence vers sa définition, les pages de contexte, les filtres, la période analysée et l’identifiant de la question. Un commentaire dans une requête SQL n’est pas équivalent au paramètre de session natif QUERY_TAG de Snowflake. Lorsque la couche d’exécution contrôle une session Snowflake stable, elle peut également définir ces mêmes métadonnées dans QUERY_TAG. Il devient alors possible de filtrer directement les requêtes par ces informations dans ACCOUNT_USAGE.QUERY_HISTORY. Il ne faut toutefois pas supposer que plusieurs appels à un outil utilisent la même session. Avec un pool de connexions, le tag doit être mis à jour ou effacé à chaque réutilisation pour éviter toute erreur d’attribution.
Ces traces nous aident à examiner l’analyse et à déterminer où apporter des améliorations.
Les questions équivalentes utilisent-elles les définitions et la portée prévues ?
Les échecs indiquent-ils un contexte manquant, une mauvaise source ou un problème d’exécution ?
Où les requêtes ou les recherches de contexte sont-elles répétées inutilement ?
Quelles questions récurrentes nécessitent un modèle d’analyse ou un rapport réutilisable ?
Si la question sur l’adoption produit des réponses différentes, la trace peut révéler une différence dans le mappage des comptes, le filtre de population ou la période analysée. Nous pouvons ensuite déterminer si la correction doit porter sur la définition des données, le routage ou les instructions de validation.
Nous améliorons encore les contrôles en comparant les réponses à celles validées par les responsables des données. Cela consiste à tester les modifications apportées au contexte et aux instructions sur un même ensemble de questions représentatives, en utilisant si nécessaire des périodes fixes ou des instantanés de données. Le bon fonctionnement des requêtes et l’augmentation de leur utilisation sont des indicateurs utiles, mais ne garantissent pas l’exactitude des réponses.
Ces traces sont utiles, mais elles ont des limites. La cohérence ne signifie pas que le langage SQL doit être identique. Des requêtes équivalentes peuvent avoir des formes différentes, et des autorisations différentes peuvent légitimement produire des résultats différents. Nous comparons donc plutôt la définition, la portée et la période. Les requêtes en lecture seule consomment tout de même des ressources ; nous veillons donc à ce que les outils restent ciblés et les périmètres d’investigation restreints. Multiplier les recherches d’informations ou les tentatives n’améliore pas automatiquement la qualité d’une réponse. L’outil d’exécution de requêtes est également permissif par défaut, de sorte qu’une attribution incomplète ne bloque pas une requête valide. Des vérifications plus strictes des métadonnées peuvent être activées, mais aucun de ces modes ne prouve l’exactitude d’une réponse ni ne modifie les autorisations d’accès aux données.
Créer votre propre agent de données
Commencez par quelques questions récurrentes, appuyées par des données approuvées et des consignes tenues à jour. Au lieu de documenter toute l’entreprise, basez-vous sur ces questions pour définir les besoins de l’agent.
Choisissez des données et des définitions autorisées auxquelles les propriétaires des données font confiance.
Connectez les connaissances métier pertinentes et clarifiez le processus d’analyse.
Évaluez le travail réalisé et définissez un processus de révision des corrections au fil de l’évolution du système.
Si vous souhaitez en savoir plus sur notre configuration chez Notion, notre guide du Centre d’aide détaille les choix de connexions, des exemples d’instructions, des conseils de routage, les workflows de maintenance et des exemples de journalisation des requêtes.
Si vous souhaitez créer un agent de données pour votre équipe, nous proposons un programme d’accès anticipé pour aider nos client·es à configurer des agents Notion alimentés par Snowflake. Contactez-nous !